早上七点,苏堤集合。绕道曲院风荷,经过玉带晴虹,回到苏堤,经过压堤桥、苏堤春晓、望山桥、锁澜桥,到达花港观鱼,再到西湖国宾馆。
夏天,太阳起得很早,起得早的人却不多。一行5人,全程总计约4公里,不紧不慢,先到G20展馆二楼喝茶叙旧,之后到紫微厅午餐。
次日,一家人再到湖畔茶居,饮茶一杯,贪享半日湖光美景。
(more…)·
这是kiki的心得,记录如下。
在孩子的养育过程中,最近对孩子的学习领悟的比较多一点。现在我想讲一下这方面的理解。
现在很多家长,对于孩子学习很头疼,担心孩子成绩不好,考不上大学,这个其实我很能理解,我也是这样过来的,一直很焦虑不知道该怎么办。
但是有一点我现在想得比较明白,那就是学习的过程比孩子成绩考了多少重要,因为写作业的过程中会锻炼人的各种能力,比如专注力,思维能力,自控力,忍耐力,抗挫折的能力,这些能力对于一个人来说是非常重要的,它们会在你未来的人生中起到很关键的作用。有些专家甚至说了更多的能力,我目前只想到这几个,因为这是我的实战经验。
我为什么说过程比结果重要呢?难道我不关注结果吗?不是的,我其实很关注结果,但是我不会因为一次两次考试的结果不好就去打孩子骂孩子,因为这件事情其实孩子并没有任何的错误,孩子其实也很想学好的。反过来说你打了孩子,骂了孩子就有效果了吗?有的时候会有一点效果,但这主要是对顺从性比较好或者比较要强的孩子会有一定的效果,不适用于绝大多数的普娃。而且就算是这种效果也是暂时的,不长久的,长期来说负面的东西会更多,所以这么做我是不赞成的。因为这会伤害孩子的自信心甚至内驱力,孩子成绩不好不是他犯了错误,更多的原因是他学习能力的问题,不是靠着你的惩罚他就能学好了的。
那么学习不好怎么办呢?首先我觉得作为家长要做的是搞清楚你的孩子,能力欠缺在哪一方面,有学习习惯不好的,有孩子本身这个年龄段就是欠缺的能力的,也有学习方法没有掌握的。那么我们怎么来解决这些问题呢? (more…)
了解InnoDB的物理存储可以为后续进一步了解其日志存储打下基础。在前述的内容,较为详细的介绍了InnoDB内部的B+-Tree存储,本文在此基础上,继续介绍,一个B+-Tree的节点(经常称作“页面”)中,如何存储单条记录的。本文,仅介绍其一般实现,并不对InnoDB记录格式的各种类型、场景做详细介绍。
这部分倒没有什么复杂的理论的,更多的是一些实践经验以及实际应用场景中各种情况的考虑与适配。
最为直接的,则是按照“数据表”各个列的元数据顺序排列即可。而事实上,这也是InnoDB实现的基本原则。但在实践中,还有很多的问题要去解决:
Default值如何存储?NULL值如何存储?变长字段如何存储?超大的字段如何存储等。DDL,例如新增一个字段、删除一个字段等一条记录分为两个部分,Record Header
目录
这里新建表,并写入两条新的数据:
DROP TABLE IF EXISTS t_r;
CREATE TABLE t_r (
  id int auto_increment primary key ,
  nick varchar(32),
  birthday date,
  password_hash char(32),
  email varchar(32)
);

INSERT INTO t_r VALUES
  (1,"zzx","1989-02-11","a76e5fc27899ada11b4eafd0b1a7a4fc",'zzx@example.com'),
  (2,"yhq","2012-05-18","b6bdc8dcddeacece09d5697145d373d9",'yhq@example.com')
;(注:最好不要这样存储hash值)
这需要一些背景知识,但并不是本文介绍的重点。在独立表空间(当前MySQL的默认行为)的情况下,:
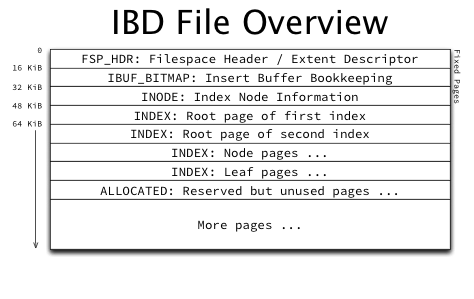
db.t_r.ibdPage即为第一个数据页面,因为这里写入的数据较少,所以,一般就存储在该页面如果对于这个问题感兴趣的话,可以参考 The basics of InnoDB space file layout 中关于“Per-table space files”的描述。可以看到,第四个页面即为INDEX: Root page of first index。
使用vim(:%!xxd)查看时,每行16 Bytes,一个页面就是1024行,第四个页面,即从3073行开始,到4096行结束。
$ view -b t_r.ibd
3073 0000c000: 646e 9e73 0000 0003 ffff ffff ffff ffff  dn.s............
3074 0000c010: 0000 0007 de81 961e 45bf 0000 0000 0000  ........E.......
3075 0000c020: 0000 0000 01d0 0002 0114 8004 0000 0000  ................
3076 0000c030: 00ce 0002 0001 0002 0000 0000 0000 0000  ................
3077 0000c040: 0000 0000 0000 0000 030c 0000 01d0 0000  ................
3078 0000c050: 0002 00f2 0000 01d0 0000 0002 0032 0100  .............2..
3079 0000c060: 0200 1d69 6e66 696d 756d 0003 000b 0000  ...infimum......
3080 0000c070: 7375 7072 656d 756d 0f03 0000 0010 004e  supremum.......N
3081 0000c080: 8000 0001 0000 0090 f05b bb00 0001 3101  .........[....1.
3082 0000c090: 107a 7a78 8f8a 4b61 3736 6535 6663 3237  .zzx..Ka76e5fc27
3083 0000c0a0: 3839 3961 6461 3131 6234 6561 6664 3062  899ada11b4eafd0b
3084 0000c0b0: 3161 3761 3466 637a 7a78 4065 7861 6d70  1a7a4fczzx@examp
3085 0000c0c0: 6c65 2e63 6f6d 0f03 0000 0018 ffa2 8000  le.com..........
3086 0000c0d0: 0002 0000 0090 f05b bb00 0001 3101 1d79  .......[....1..y
3087 0000c0e0: 6871 8fb8 b262 3662 6463 3864 6364 6465  hq...b6bdc8dcdde
3088 0000c0f0: 6163 6563 6530 3964 3536 3937 3134 3564  acece09d5697145d
3089 0000c100: 3337 3364 3979 6871 4065 7861 6d70 6c65  373d9yhq@example
3090 0000c110: 2e63 6f6d 0000 0000 0000 0000 0000 0000  .com............
3091 0000c120: 0000 0000 0000 0000 0000 0000 0000 0000  ................
3092 0000c130: 0000 0000 0000 0000 0000 0000 0000 0000  ................
     ......
4094 0000ffd0: 0000 0000 0000 0000 0000 0000 0000 0000  ................
4095 0000ffe0: 0000 0000 0000 0000 0000 0000 0000 0000  ................
4096 0000fff0: 0000 0000 0070 0063 646e 9e73 de81 961e .....p.cdn.s....关于该格式的描述,可以参考innobase/rem/rem0rec.c中的注释说明部分,有比较详细的说明。
/*
...
| length of the last non-null variable-length field of data:
  if the maximum length is 255, one byte; otherwise,
  0xxxxxxx (one byte, length=0..127), or 1exxxxxxxxxxxxxx (two bytes,
  length=128..16383, extern storage flag) |
...
| length of first variable-length field of data |
| SQL-null flags (1 bit per nullable field), padded to full bytes |
| 4 bits used to delete mark a record, and mark a predefined
  minimum record in alphabetical order |
| 4 bits giving the number of records owned by this record
  (this term is explained in page0page.h) |
| 13 bits giving the order number of this record in the
  heap of the index page |
| 3 bits record type: 000=conventional, 001=node pointer (inside B-tree),
  010=infimum, 011=supremum, 1xx=reserved |
| two bytes giving a relative pointer to the next record in the page |
ORIGIN of the record
| first field of data |
...
| last field of data |
...
*/在一个页面内,InnoDB存储每条物理记录时,都会在记录中存储一个“指针”,该“指针”指向下一条记录的物理位置,并且在实现时,该“指针”是以当前记录偏移的方式存储的。
所以,如果我们能够找到页面内的第一条记录,那么就可以依此顺序的遍历整个页面内的记录了。找到第一条记录大概有很多的方法,这里说说InnoDB的实现:infimum和supremum。简单来说,InnoDB会在页面中存储一个infimum记录,该记录可以认为是该页面的极小值,该记录中的“Next Record”即为实际的该页面最小值。
infimum和supremum是每个InnoDB页面内存储两条物理记录,分别代表“起始最小记录”和“结束最大记录”。所以如果使用上述的下一条记录“指针”遍历页内所有记录,则总是从infimum开始,以supremum结束,中间就是所有的用户记录。
在页面找到infimum和supremum记录的方法有两种:
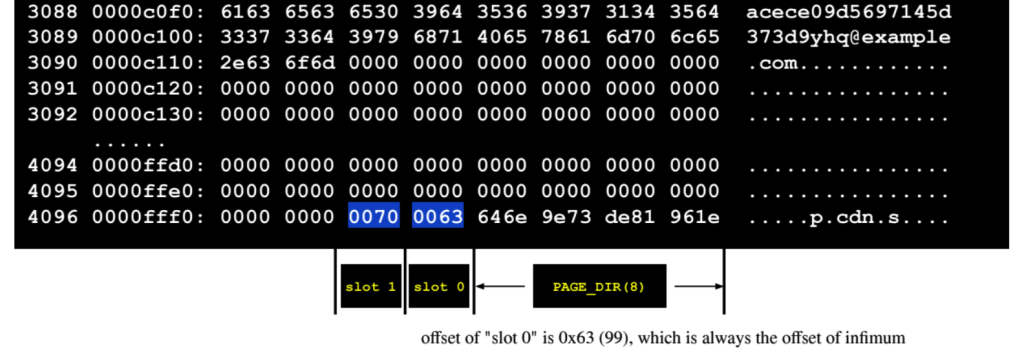
infimum和supremum在页面的偏移,总是99和112Page Directory的slot中查找:第一个slot总是指向infimum;最后一个slot总是指向supremum在前文“B+-Tree的内部搜索:InnoDB的实现”,已经概述了slot 0中总是存储的infimum记录,则可以通过页面底部向前偏移PAGE_DIR(InnoDB中PAGE_DIR的值是8),然后找到slot 0对应的记录的偏移,即infimum的偏移,而因为一个slot存储的偏移地址都是2 bytes 。所以,在页面内的倒数第10、9个字节,即为infimum在页内的偏移地址,即0x0063。
这里有两点需要注意:
slot内存储的则是页内绝对偏移。理解上述两点,对于理解后续内容是很重要的,要不然,可能会算错地址。
例如,上述的slot 0中记录的infimum的偏移0x0063就是绝对偏移;而infimum中存储的next record偏移,则是相对于infimum的偏移地址。例如,next record偏移是00 1d,那么意味着这条记录的偏移是0x0063+0x001d,即绝对偏移是:0x0080。
按照上述方法,这里已经找到第一条(按大小顺序)记录的“记录指针”,即0x0080。把记录的头部(record header)和记录本身数据从上述二进制数据单独取出来,如下:
                                   |<-record header->|
3080 0000c070: ................... 0f03 0000 0010 004e  supremum.......N
               |<---------- field data   ----------->|
3081 0000c080: 8000 0001 0000 0090 f05b bb00 0001 3101  .........[....1.
               ^
               |--> record pointer/offset (the origin of the record)
3082 0000c090: 107a 7a78 8f8a 4b61 3736 6535 6663 3237  .zzx..Ka76e5fc27
3083 0000c0a0: 3839 3961 6461 3131 6234 6561 6664 3062  899ada11b4eafd0b
3084 0000c0b0: 3161 3761 3466 637a 7a78 4065 7861 6d70  1a7a4fczzx@examp
3085 0000c0c0: 6c65 2e63 6f6d ........................  le.com..........
              |<-field data->|
注:
record pointer后,是无法简单的、直接获得record header长度的,也无法简单的获取记录本身的长度的。而是需要根据元数据库、以及record header中的部分数据,计算而来。record header 的长度获取,是比较复杂的。这里做一定的简化,描述如下:
record pointer向前(record header方向)移动,5个bytes是相对固定的,包含了
2 bytes: next record3 bits: record type13 bits: the order number of this record4 bits: the number of records owned by this record(slot) 4 bits: delete mark and mark a predefined minimum recordrecord pointer再向前的 n个bytes则用于存储 null 的field,该存储模式为按标记位存储,且按bytes补齐:
5个fields,则需要1 bytes,作为标记位;如果某个field为null则对应的bit即标记位1n=1record pointer再向前的m个bytes则用于存储变成列的实际长度。本示例中,共有两个变成列,故这里的 m = 2这里以页面中的第一条记录为示例,继续解析该记录的头部信息。详情如下:
(<------------- record header / hex ----------------->) (<----- data/hex ----->)
0f03 0000             0010             004e             8000 0001 0000 0090 f05b

(hex)(<---------------  binary   -------------------->) (<----- data/hex ----->)
0f03 0000000000000000 0000000000010000 0000000001001110 8000 0001 0000 0090 f05b
| |  |<----->|<->|<-->|<---------->|   |<------------>|
| |  |       |   |    |            |   |
| |  |       |   |    |            |   |-->(2 bytes) next record
| |  |       |   |    |            |
| |  |       |   |    |            |-->(3 bits) record type: 000=conventional
| |  |       |   |    |
| |  |       |   |    |-->(13 bits) the order number of this record
| |  |       |   |
| |  |       |   |-->(4 bits) the number of records owned by this record(slot)
| |  |       |
| |  |       |-->(4 bits) delete mark and mark a predefined  minimum record
| |  |
| |  |-->(8 bits) null-flag (here ,no null field at all, 5 field, so 1 bytes )
| |
| |-->(1 byte) length of 1st variable field, so length is 03
|
|-->(1 byte) length of 2nd variable field, so length is 0f(15)
结合记录头部信息,再结合“元数据信息”,则就可以解析出记录本身的信息了。
有很多人对这个问题已经有了非常深入到说明或研究,如下给出主要的参考链接:
InnoDB行格式类型:REDUNDANT、COMPACT 、DYNAMIC 、COMPRESSED等延伸讨论:
B+Tree、B+-Tree 均指B+-TreeB-Tree指狭义的、经典的B-Tree,该结构主要参考:了解 InnoDB 的索引结构:B-Tree 基础B-Tree也会指代B+-Tree或其他B-Tree变种;这种用法也是非常广泛的,例如,在MySQL/InnoDB的文档中,仅使用B-Tree,而更为准确的说是B+-TreeNode)、“页面”(Page)、“数据块”、“块”(Block)等均指存储B-Tree或B+-Tree的节点,即树结构的节点,内部可以存储多个键值。在不同的语境下,大家会用不同的词,例如通常在算法课程/书籍中,会更多的使用“节点”(Node);而在数据库实现中,则更喜欢用“页面”(Page)或“块”(Block);更为细节的,如果在内存中,则更多的时候用“页面”(Page),在磁盘上,则更多的“块”(Block)。各种情况下混用的也很多,并没有什么问题。Entry)等是指完整的“键值对”,在叶子节点中,通常包括\( (k_i, a_i) \);在非叶子节点中可能的形式是:\( (k_i,p_i, a_i) \) 或 \( (k_i, p_i) \)TAOCP 是 “The Art of Computer Programming”的缩写一直以来实现数据库的零数据丢失都是非常有挑战,尤其是跨可用区的场景下。很多核心系统为了实现这一点都投入了大量的智慧和金钱。Amazon RDS在文档都明确的写到,数据库在多AZ之间的数据是保持同步的(注:同步是指数据写入两边要同时写成功,即使一边不可用,已经提交的事务在另一边一定是成功的)。一直以来,我也很好奇Amazon RDS在哪个层面实现的同步复制。
这个问题原本也是没有太大疑问的,可以推测应该是通过EBS层面的块复制来下。依据有两方面,有一些公开的Amazon RDS一些架构图中可以看到有EBS复制的箭头说明。另外,还有一点,只有通过EBS的复制实现跨可用区数据一致性,才可能在RDS支持的多种数据库,如MySQL、SQL Server、Oracle等,上保持架构上一致。否则,不同数据库类型的高可用和复制架构可能相差很大。
但是,之前很长时间我还是有一个疑问,Amazon RDS复制到底是在数据库逻辑层实现的还是在EBS物理层实现的。
既然有上面的猜测,那为什么产生了这个疑问呢?是因为,在Aurora很多的对外介绍材料(包括论文、架构介绍的slide)中,会放一个MySQL架构来突出Aurora的架构优势。这个图一直让我误以为Amazon RDS使用了数据库的binlog的复制。在了解Aurora的时候大家经常会看到如下架构图作为反面案例(参考): (more…)
最近,周陌有一项作业是编一个童话故事。想起,前段时间阳台上的一只松鼠,加上周陌每天弹钢琴的“哀嚎”,于是一起编了下面的故事:
